Voice Chorus
Voice chorus Generation System
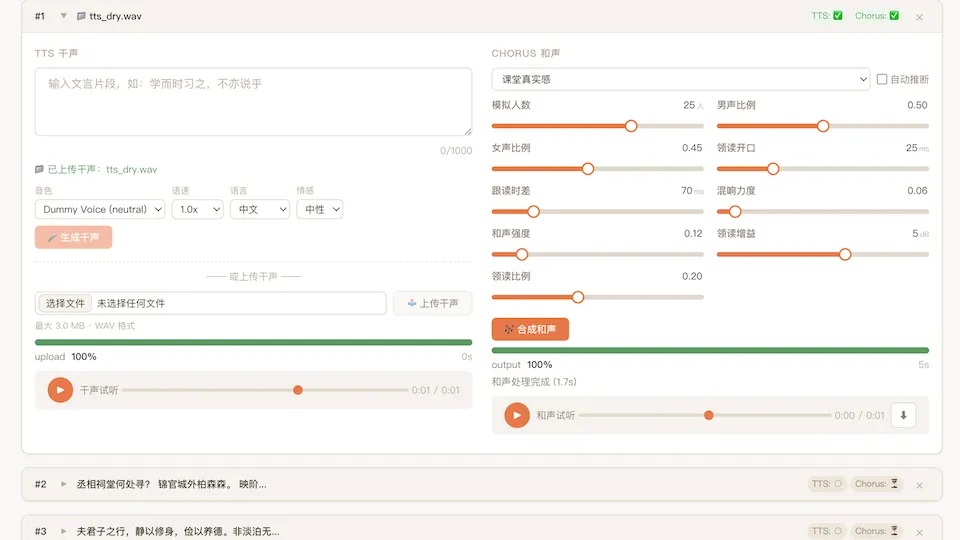
诗文诵读是中华传统文化教育的重要组成部分。在数字内容创作、有声课本、短视频配音等场景中,经常需要生成一群人整齐朗读的音频素材。然而,真实的多人录音成本高、调度困难,且往往缺乏理想的声学环境。
基于此需求,实现了一套齐声诵读生成系统,能够将一段独白转化为极具临场感的立体声齐读音频,并特别为古文诵读场景进行了针对性优化。系统在保真度、群感融合度与美学表现上表现比较出色。
能力简介
该系统输入单声道独白片段,通过精细模拟语速差异、音高散布、性别分化、和声层次、空间距离、朗读跟随以及句尾渐慢等多种自然现象,合成并输出高度真实的一群人齐声朗读的立体声音频。核心能力介绍:
- TTS 干声生成:文本 → 云端 TTS → 干声 WAV;支持音色选择、重新生成
- 干声上传:直接上传预录 WAV,跳过 TTS 进入和声处理
- 多片段工作台:多片段录入,每片段独立音色与多参数和声调节,配置复用
- DSP 和声引擎:多声部合成(音高散布、性别分化、齐读层次、空间距离等)
- 拼接母带:全部片段拼接 + 后处理 + 交叉淡化 + LUFS 响度标准化
- 鉴权保护:访问控制,访问码保护(token+有效期),可选
- 试听预览:试听 TTS 干声与和声成品,下载带进度反馈
系统以单声道干声为输入,通过调制延迟、性别化音高偏移、共振峰塑形、分层朗读、距离感 EQ 以及句尾自然渐慢等 DSP 技术,在多维随机化中再现真实课堂的声学特征。同时,引入自适应参数推断使系统能够根据输入音频的时长、基频、动态和频谱特性自动设定最优参数,大幅降低使用门槛。针对移动端播放,还集成了响度标准化与频率适配模块,确保成品在手机扬声器上同样饱满清晰。
架构简述
单应用架构:一个 Vue 前端 + 一个 FastAPI 后端 + 一个 Nginx 反向代理。
容器化部署,可扩展为集群部署。任务同步需要额外的中间件。
支持本地 CLI 应用。
预设场景
系统内置若干套预设,适应多种常见场景,开箱即用。部分介绍如下:
- 真实感课堂:30 人、延迟开口、全效果开:领读跟读、Rubato、节奏同步、共振峰偏移、AGC 等,适合课堂诵读。
- 快速预览:12 人、低开销、禁用 VAD、截取前 10 秒,适合快速试听效果。
- 移动端播放优化:28 人、高响度、单声道兼容、硬限幅。
- 录音室品质:35 人、全效果开启、高和声比例、高领读增益、大混响。
用户可以在预设的基础上进一步调节,并可将自定义配置通过 Preset Mode 以结构化的形式(如 JSON)持久化到本地文件,加载时优先加载用户预设,同名用户预设覆盖内置预设。
项目现状
打磨中,已上线于小范围内测体验,将持续优化音频效果和使用交互。